Demo: messy CSV files to a clean Excel report with Python

Prabhudutt Mishra


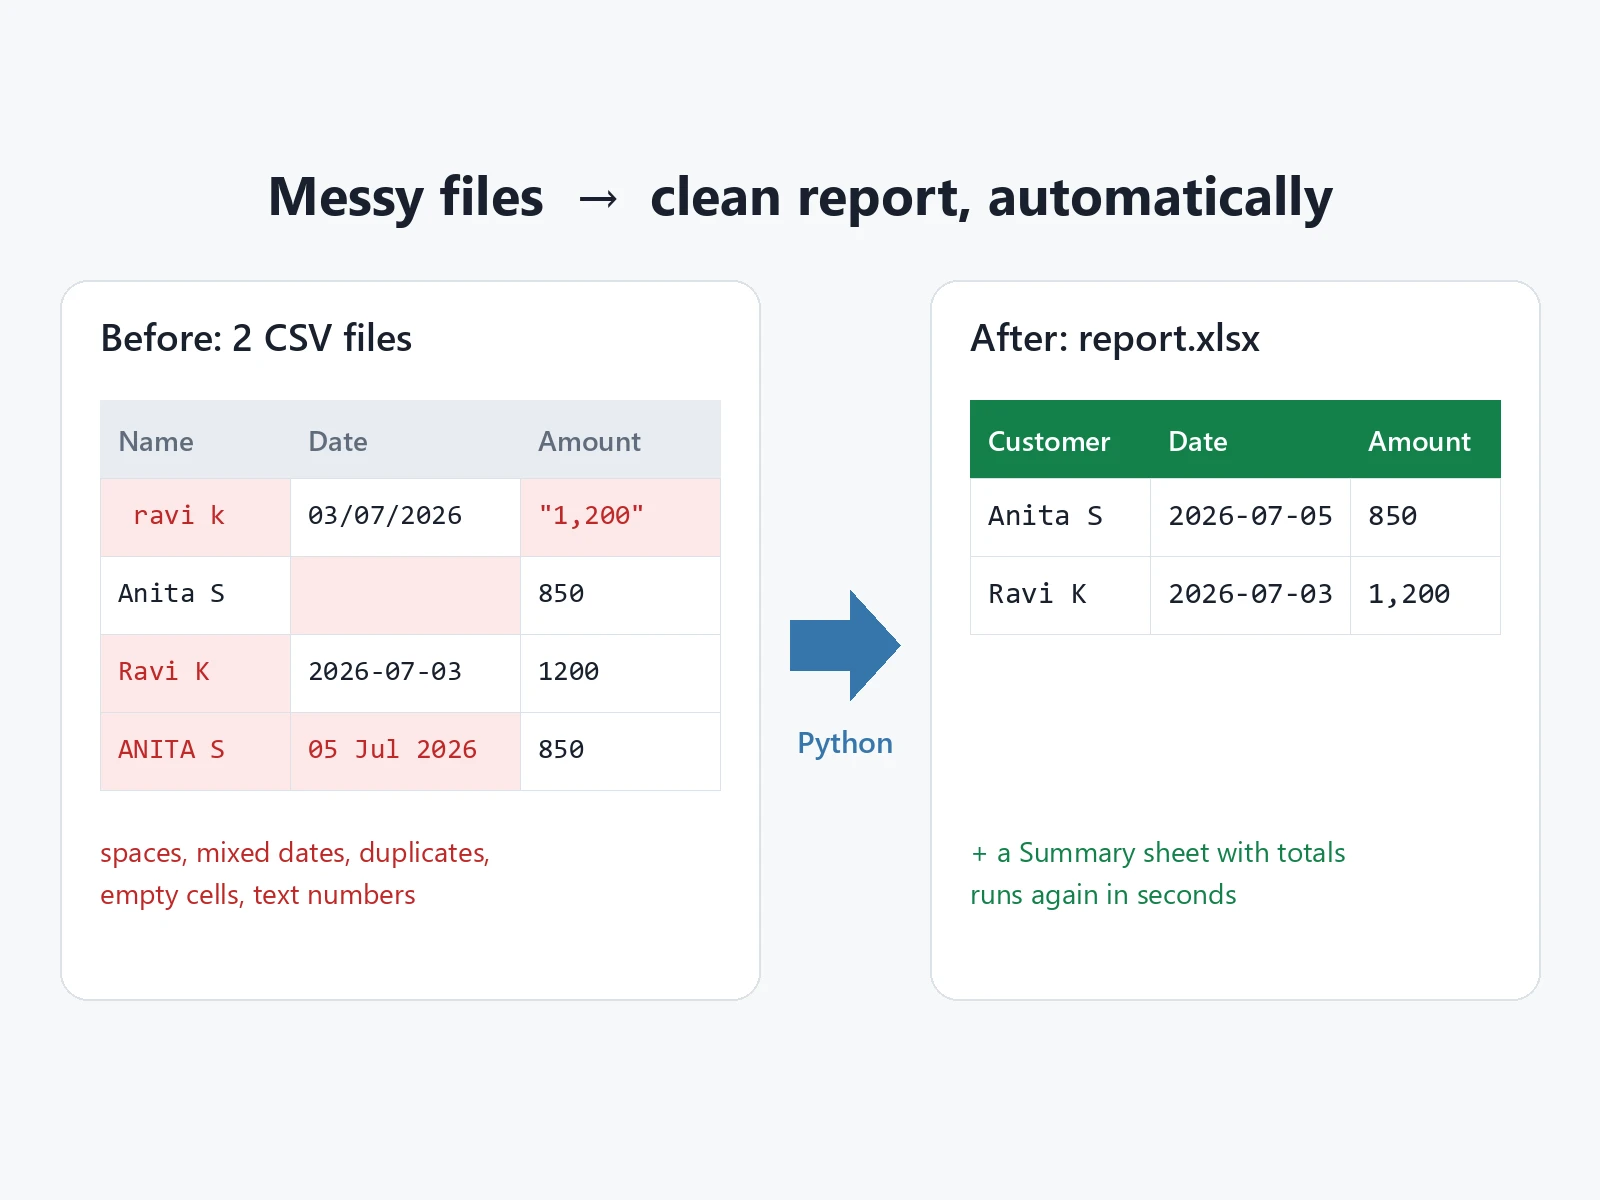
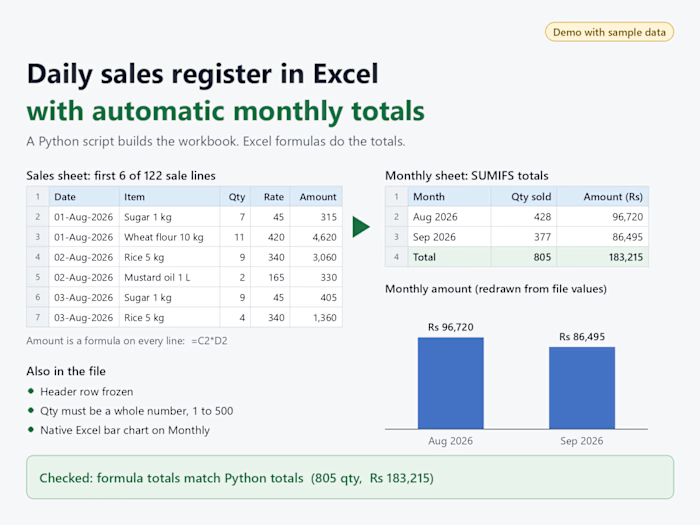
A demo I built with made-up sample data to show what my Excel and CSV scripts do. It is my own sample, not client work.
The input is two CSV files with the usual problems: extra spaces, names in mixed case, dates in three different formats, a number stored as text, an empty cell and duplicate rows.
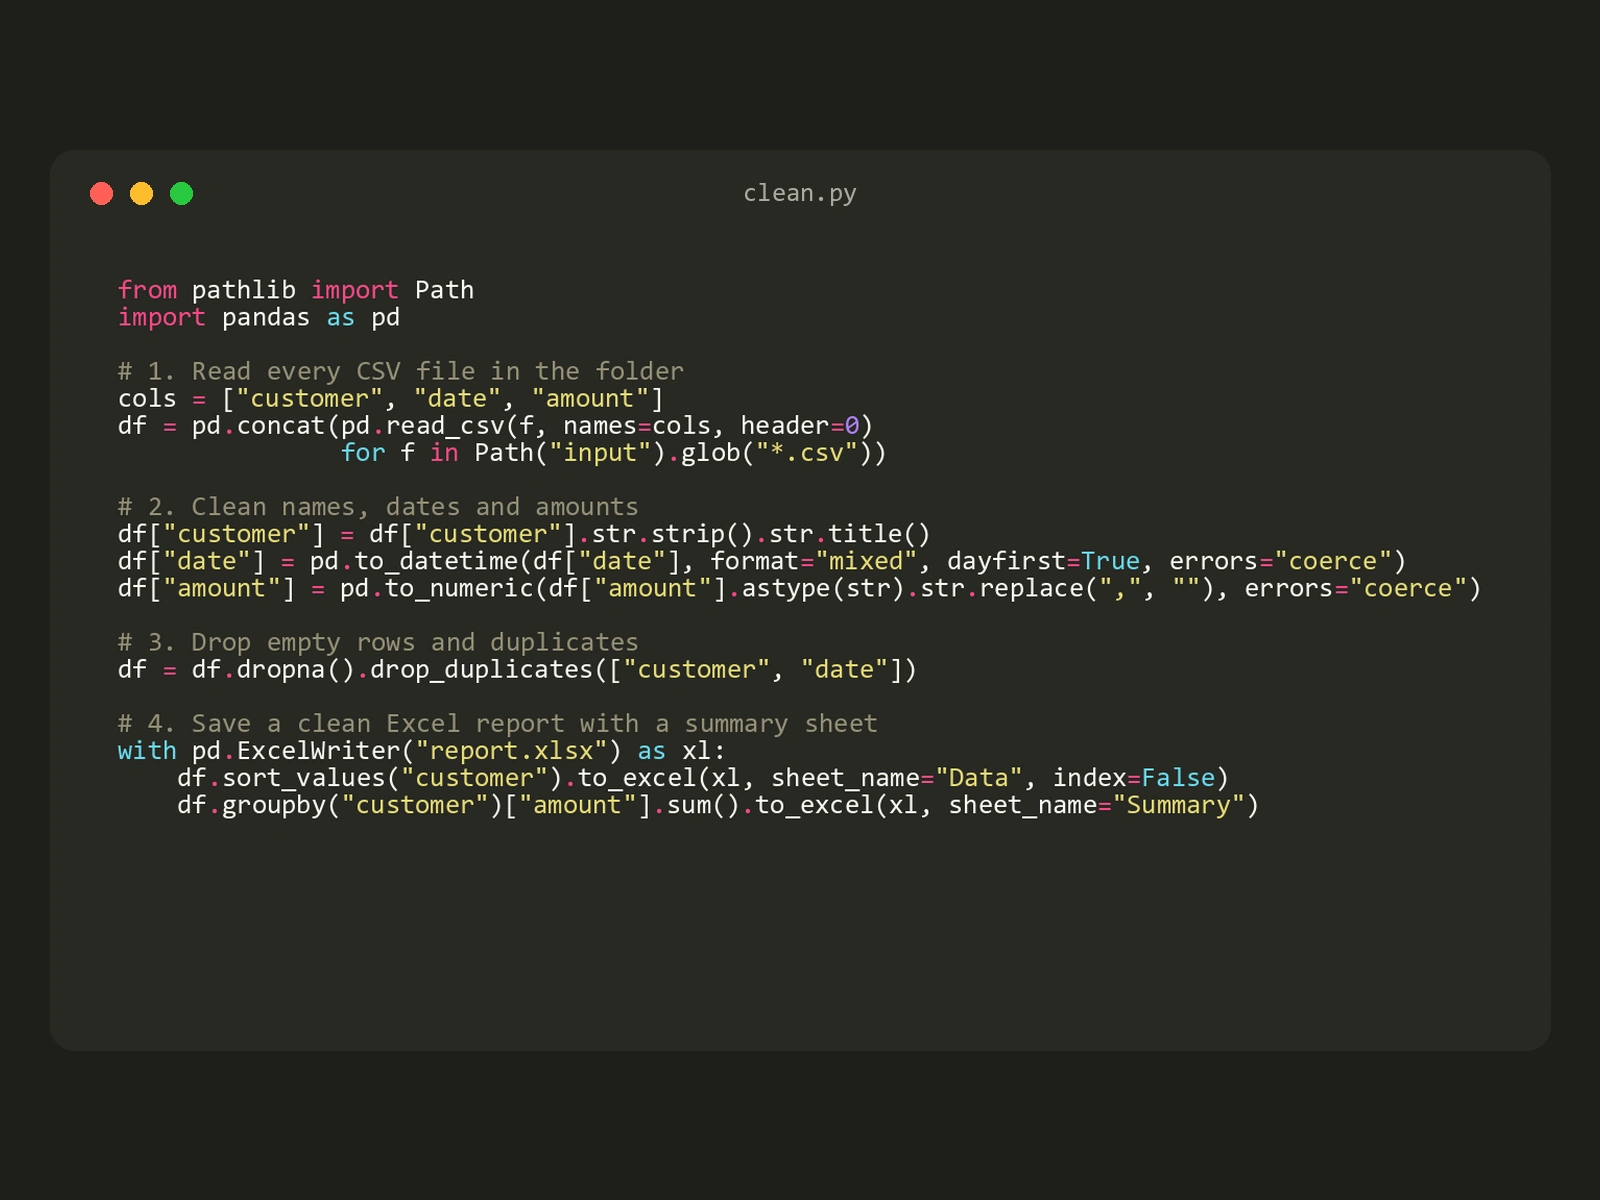
The script reads every CSV file in a folder, cleans the names, dates and amounts, drops rows with missing values and duplicate rows, and saves report.xlsx with a clean Data sheet and a Summary sheet with totals per customer. Running it again on new files takes seconds.
The whole script is about 20 lines of Python with pandas, shown below.
The same approach works for merging a folder of Excel files, pulling tables out of text-based PDFs, or sending the results by email or to Google Sheets.
I used AI tools to speed up the routine parts, then ran and checked the script on the sample files myself.
Like this project
Posted Oct 23, 2026
A demo script I built with sample data: two messy CSV files cleaned and merged into one Excel report.
Likes
0
Views
0
Timeline
Oct 16, 2026 - Oct 16, 2026