The network for creativity
Join 1.25M professional creatives like you
Connect with clients, get discovered, and run your business 100% commission-free
Creatives on Contra have earned over $150M and we are just getting started
Back to feedPost

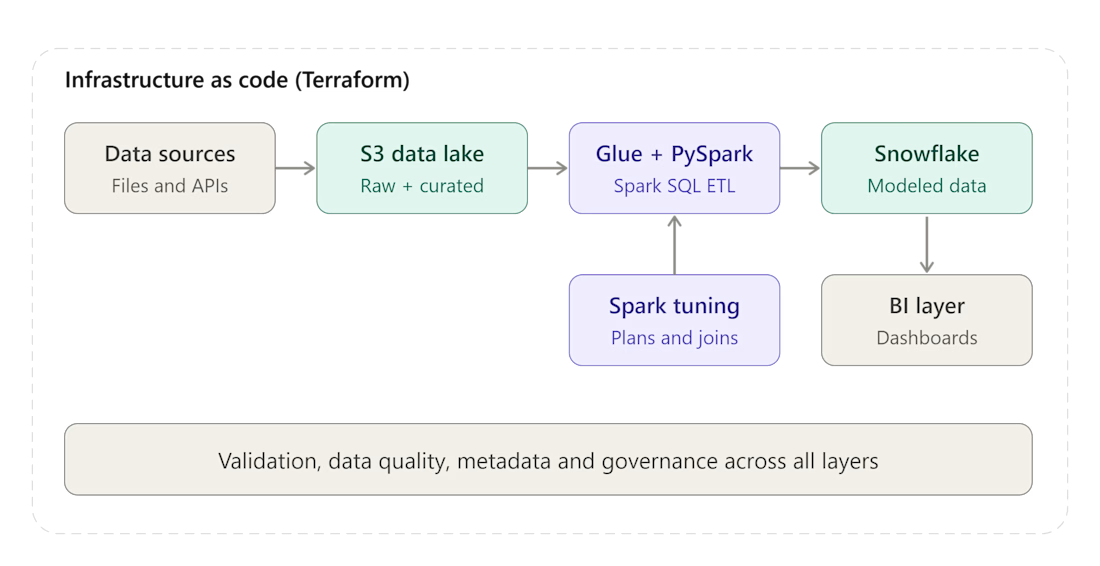
Enterprise Data Platform
Technology & Tools: Python, Java, SQL, PySpark, Apache Spark, Spark SQL, AWS, Amazon S3,
AWS Glue, PostgreSQL, Snowflake, BI, Terraform, ETL, ELT, Data Lake, Data Warehouse, Data
Lakehouse
Role: Data Engineer
• Designed scalable end-to-end ETL/ELT pipelines and batch data processing workflows
using Python, PySpark, Spark SQL, AWS, and Snowflake.
• Defined ingestion, transformation, validation, data flow, and data modeling patterns
for an enterprise Data Lake, Data Warehouse, and Data Lakehouse platform.
• Reviewed Spark execution plans and optimized transformations, joins, aggregations,
partitioning, and processing performance for distributed workloads.
• Used Terraform for Infrastructure-as-Code and collaborated across engineering,
product, and business teams to deliver scalable data solutions.
• Wrote and optimized Advanced SQL queries and supported data quality, reliability,
consistency, metadata, and governance requirements.


The network for creativity
Join 1.25M professional creatives like you
Connect with clients, get discovered, and run your business 100% commission-free
Creatives on Contra have earned over $150M and we are just getting started





Related posts


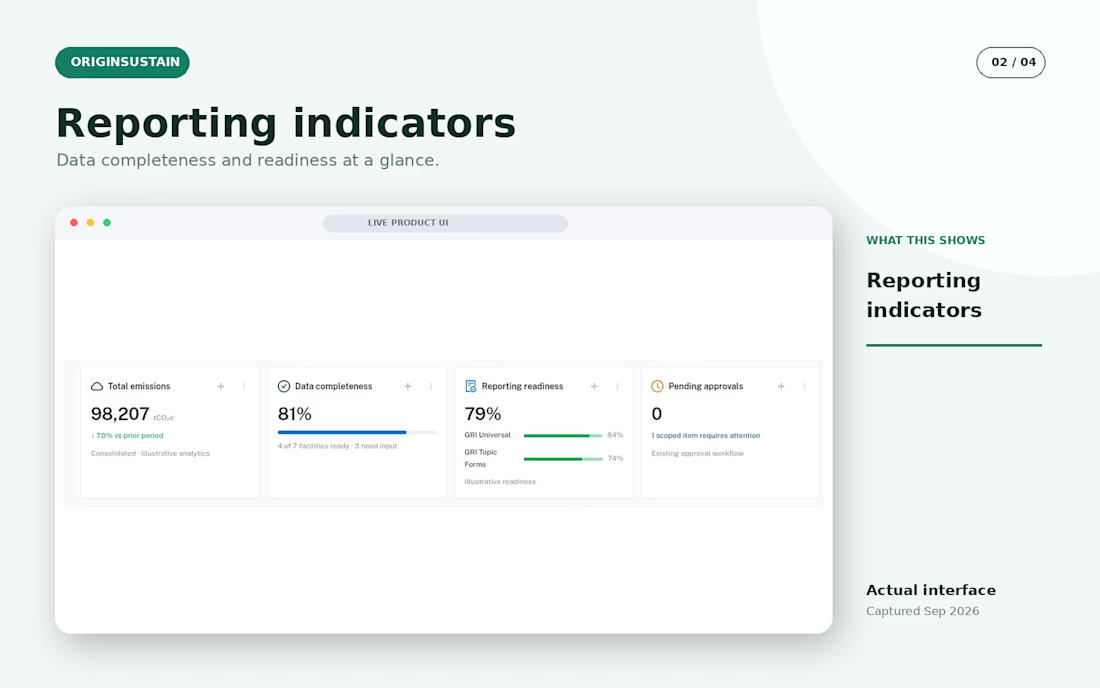
ESG reporting is a workflow problem as much as a data problem: teams need applicability rules, evidence, consolidation, review, and approvals before a report is ready.
For OriginSustain, I built NestJS/TypeScript backend services, PostgreSQL and Redis/BullMQ processing, and AWS/Docker delivery with CI/CD. OpenAI API and RAG support part of the reporting flow. The screens here are from the product’s illustrative command center; the numbers are demo values, not client outcomes.
The full backend case study: https://contra.com/p/WvNXbmQR-origin-sustain-or-multi-tenant-esg-reporting-backend



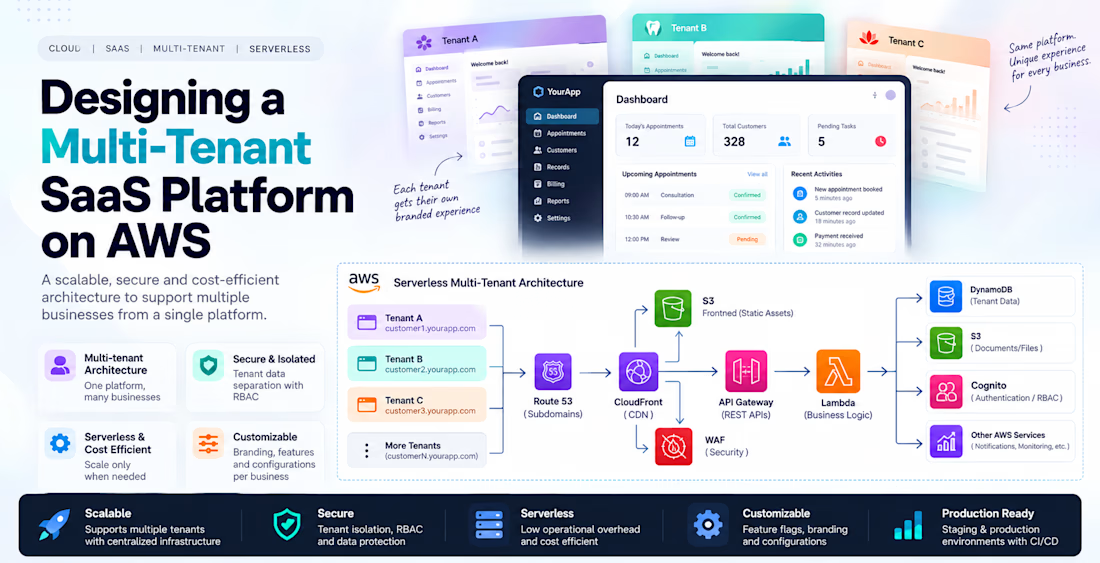
Designing a Multi-Tenant Serverless SaaS Platform on AWS
One app. Many businesses. Completely separated data. Zero infrastructure drama.
I’m currently designing a multi-tenant SaaS platform where each customer gets an isolated experience, configurable features, and their own branded subdomain — while the backend stays centralized and serverless.
What I’m building🚀
The platform is being designed to support dozens of independent business tenants from a single AWS architecture, while keeping tenant data isolated, authentication secure, infrastructure cost-efficient, and deployments centralized.
Tech stack:
AWS Lambda • API Gateway • DynamoDB • S3 • CloudFront • Cognito • Route 53 • WAF • Terraform • React • TypeScript
Cloud Architect / DevOps Lead
I’m responsible for designing the AWS architecture, tenant-isolation model, authentication flow, environment strategy, deployment approach, infrastructure automation, and scalability model for the platform.

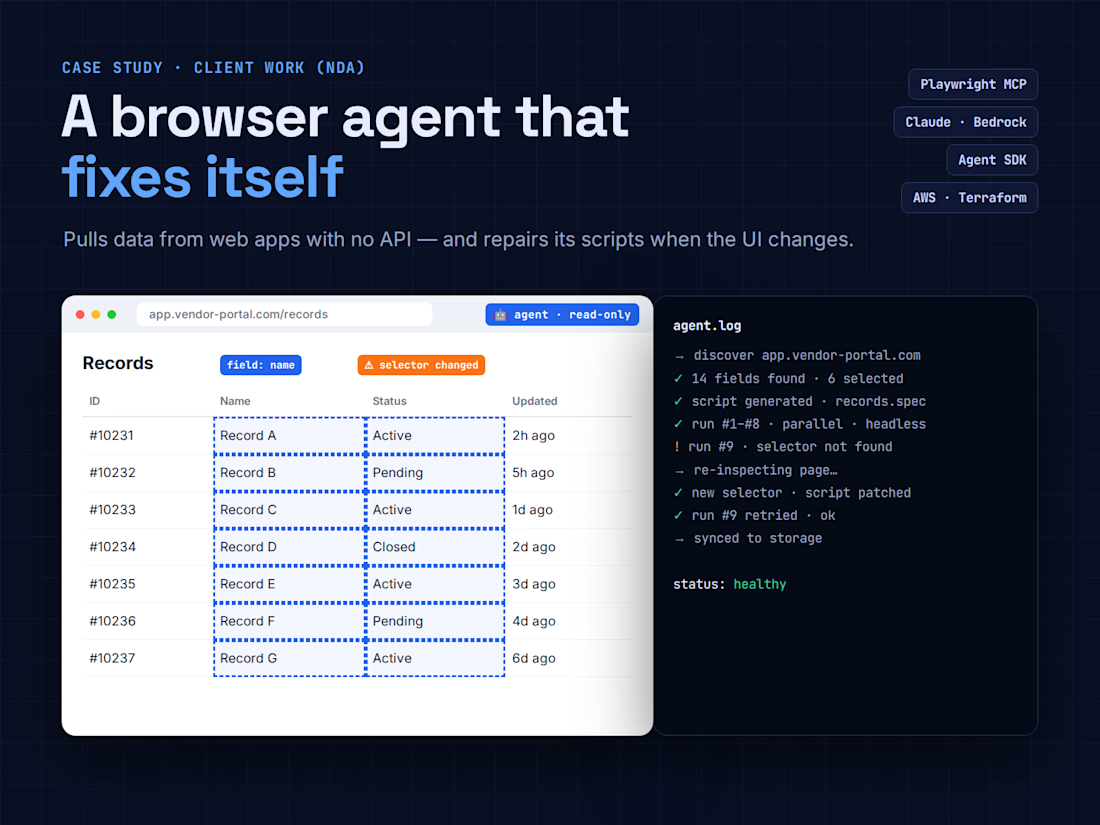
Hand-written scrapers break every time a vendor changes its UI. So I'm building an AI browser agent that learns a new web app, writes its own Playwright scripts, runs them in parallel, and repairs them itself when a selector breaks. Read-only by design, API-first, human review for critical changes. Claude on Bedrock + Playwright MCP + AWS.