The network for creativity
Join 1.25M professional creatives like you
Connect with clients, get discovered, and run your business 100% commission-free
Creatives on Contra have earned over $150M and we are just getting started
Back to feedPost

Conciliar inventario por SKU: conservar la incertidumbre y comprobar los resultados
Conciliar inventario exige identificar cada producto, validar su cantidad y comprobar si hay información suficiente para calcular una diferencia. Esta demostración propia, con desarrollo asistido por IA y datos sintéticos, compara existencias esperadas y conteos físicos en Python usando únicamente su biblioteca estándar.
El contrato de entrada es pequeño: ambos CSV deben llevar exactamente la cabecera sku,quantity. El SKU identifica cada producto y admite letras mayúsculas, números, guiones y guiones bajos, con una longitud máxima de 64 caracteres. Su primer carácter debe ser una letra o un número. Las cantidades deben ser decimales ordinarios no negativos. El programa conserva el texto recibido; no corrige automáticamente las minúsculas de un identificador ni interpreta una cantidad vacía como cero.
La conciliación agrupa los registros de cada archivo por SKU válido. Para comparar un producto necesita exactamente una fila válida en cada origen. Si encuentra dos filas con el mismo identificador, marca ese producto como blocked_duplicate. No suma las cantidades ni escoge la última aparición: cualquiera de esas decisiones introduciría una interpretación que los archivos no justifican.
El ejemplo de LABEL-004 muestra el problema. El inventario esperado indica 300, mientras el conteo contiene 300 y 299. Elegir la primera fila produciría una coincidencia; elegir la segunda, una diferencia de una unidad. El reporte deja la diferencia vacía y conserva las referencias a las dos líneas del conteo.
La demostración usa dos archivos sintéticos. El primero, expected.csv, contiene:
sku,quantity
TAPE-001,18
BOLT-002,120
CABLE-003,12.50
LABEL-004,300
FILTER-005,10
GLOVE-006,40
SEAL-007,25
PAINT-008,7.25
El archivo counted.csv contiene:
sku,quantity
TAPE-001,18
BOLT-002,117
CABLE-003,12.40
LABEL-004,300
LABEL-004,299
FILTER-005,-2
GLOVE-006,39.5
SPARE-009,5
El programa escribe cuatro archivos: un reporte JSON, una conciliación por SKU, un listado de incidencias y una auditoría de entrada. Los dos CSV originales se leen sin modificarlos. La auditoría guarda el origen, el número de línea, el SKU, la cantidad recibida y el resultado de validación de cada registro.
En estos datos, FILTER-005 tiene una cantidad de -2, que incumple el contrato. Aparece como blocked_invalid; su diferencia queda vacía. El informe conserva el valor negativo en la auditoría. Si el identificador fuera inválido, la fila seguiría registrada como incidencia, aunque no pudiera incorporarse a un grupo de conciliación.
Los productos ausentes requieren otra distinción. SEAL-007 y PAINT-008 aparecen en el inventario esperado, pero carecen de conteo: reciben missing_count. La ausencia de una observación no demuestra que haya cero existencias. En sentido contrario, SPARE-009 recibe unexpected_sku porque solo aparece en el conteo. Ninguno de estos casos genera una resta.
Cuando las dos cantidades son válidas y únicas, la definición es explícita: diferencia igual a contado menos esperado. Para BOLT-002, el resultado es 117 − 120 = -3. Para CABLE-003, es 12.40 − 12.50 = -0.10. La implementación utiliza Decimal y ajusta su precisión según la longitud de los valores de entrada; evita introducir aproximaciones de coma flotante binaria en estas restas.
El resumen también debe cuadrar. Hay 16 registros de entrada: 15 válidos y uno inválido. Eso describe la validación de cada fila, no la corrección del inventario. Las dos filas de LABEL-004 son válidas individualmente y forman un grupo duplicado. Los nueve SKU se distribuyen entre una coincidencia, tres diferencias, un bloqueo por duplicado, un bloqueo por dato inválido, dos conteos ausentes y un SKU inesperado.
Con estos datos, el programa devuelve código de salida 2 y needs_review: true: genera los reportes, pero hay resultados que requieren revisión. El código 0 queda reservado para una conciliación sin incidencias y con todos los productos coincidentes. Separar ambos resultados permite a otro proceso reconocer que obtener archivos de salida no basta para dar el inventario por resuelto.
El alcance termina en esos reportes. La herramienta supone una unidad consistente por SKU en ambos archivos; no convierte unidades ni actualiza un sistema de existencias. Tampoco suma cantidades de productos diferentes. La siguiente decisión se apoya en el detalle: localizar cada diferencia o bloqueo mediante su SKU y sus líneas de origen, corregir los datos cuando corresponda y volver a conciliar.
El script y las pruebas de esta demostración están disponibles para revisión técnica a solicitud.
The network for creativity
Join 1.25M professional creatives like you
Connect with clients, get discovered, and run your business 100% commission-free
Creatives on Contra have earned over $150M and we are just getting started
Trending
retrofuturism
Share your favorite designs from the past exploring the distant future. Or your own take on the aesthetic 🚀
halftone
Dots. Texture. Grain. Let's see your designs using the halftone technique.

Midjourney
Creatives are showing off what they're making with Midjourney.
colorgrade
Video editors sound off: How do you enhance the mood of your video in color grading?
Related posts

CSV Data Cleaner & Analyzer — A Python script I built that cleans messy CSV data (missing values, inconsistent formatting, duplicates) and generates summary statistics plus a chart using pandas and matplotlib. This is the kind of work I do for clients who need spreadsheets organized and ready to use.
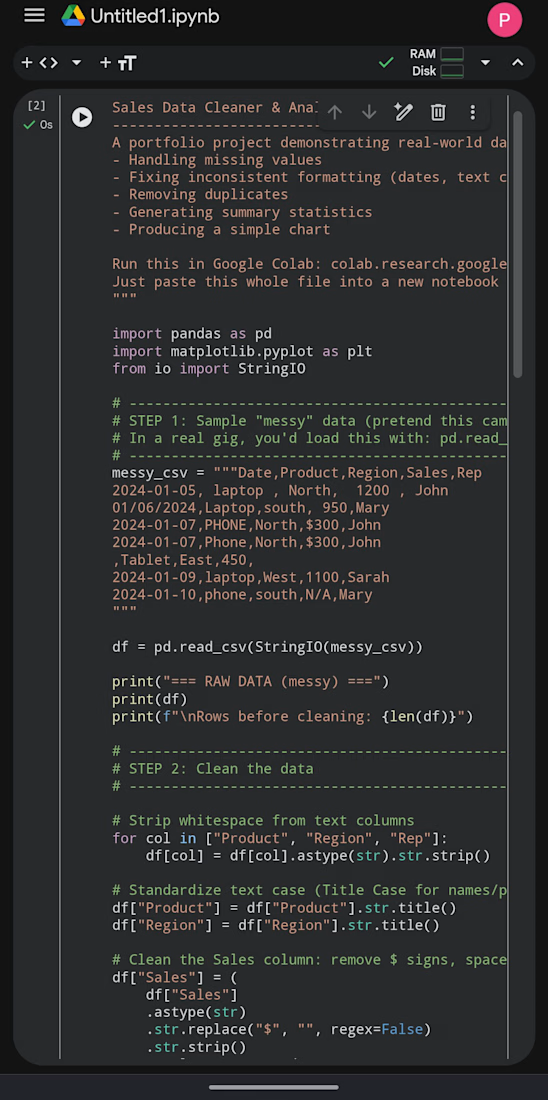

Perfect Python script. You should also consider checking out OpenRefine, as it is very effective for data cleaning and handles duplicate records particularly well.

CRM SaaS Platform — Product, Design & Frontend
Owned research, design, and frontend build for a multi-tenant CRM platform plus its blog/SEO strategy.
Full-cycle ownership of a B2B CRM SaaS product: competitor research and scoping, complete UI design from scratch, and a production Next.js/React/TypeScript frontend built on a typed API layer shared with the backend team. Also drive the product's content and SEO strategy.
#Next.js #React #TypeScript #Product Design #UI/UX
#Tailwind CSS


Building the frontend on a typed API layer shared with backend is the part that keeps a solo full-cycle build from turning into duplicated contracts down the line - worth more than the UI polish.