LLM Fine-Tuning & CustomizationRAHUL KP
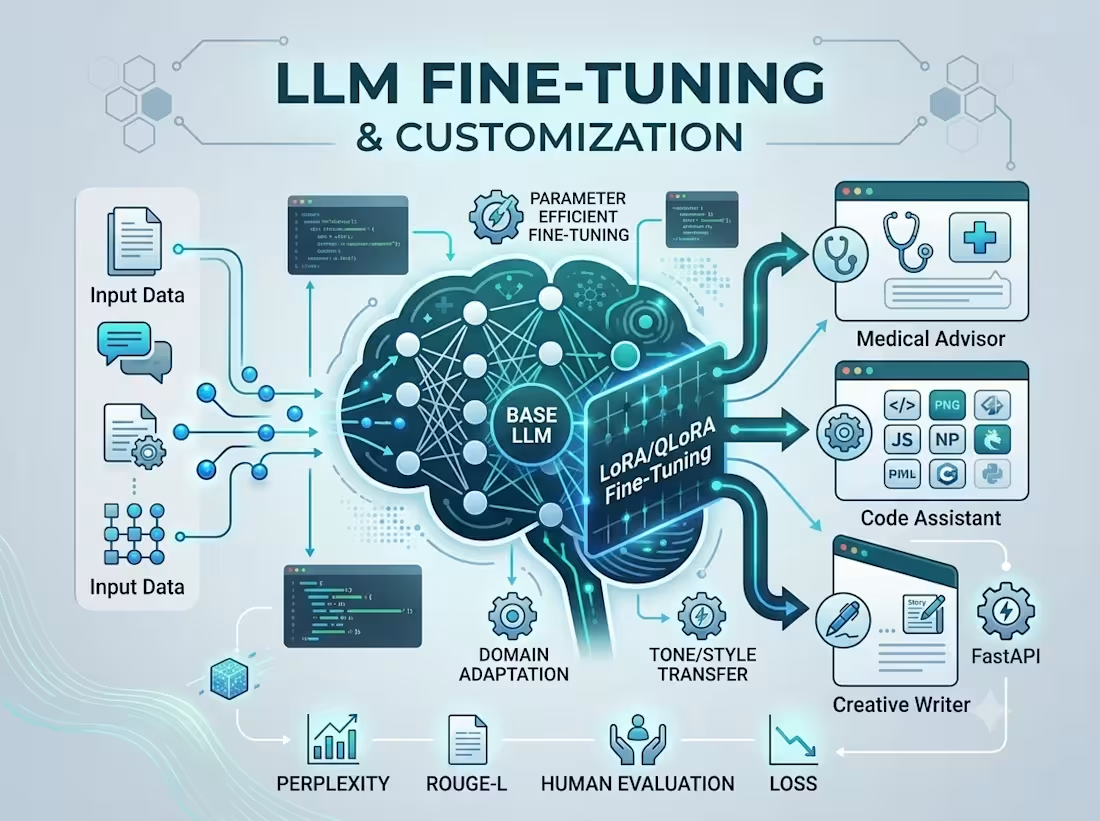
I fine-tune open-source Large Language Models (LLMs) on specialized domain datasets for specific tasks, tone, and performance requirements.
What's included:
• Efficient fine-tuning using LoRA and QLoRA techniques
• Dataset formatting, cleaning, and instruction-tuning setup
• Model evaluation, validation, and quantization (GGUF/AWQ)
• Exported model artifacts ready for low-latency inference
RAHUL's other services
Starting at$100
Duration1 week
Tags
LLMs
Generative AI
Fine-Tuning
Service provided by
RAHUL KP Kochi, India
LLM Fine-Tuning & CustomizationRAHUL KP
Starting at$100
Duration1 week
Tags
LLMs
Generative AI
Fine-Tuning
I fine-tune open-source Large Language Models (LLMs) on specialized domain datasets for specific tasks, tone, and performance requirements.
What's included:
• Efficient fine-tuning using LoRA and QLoRA techniques
• Dataset formatting, cleaning, and instruction-tuning setup
• Model evaluation, validation, and quantization (GGUF/AWQ)
• Exported model artifacts ready for low-latency inference
RAHUL's other services
$100